| Humanity's Last ExamNo tools · high reasoning effort · reported later, in Introducing GPT-5 for developers | 16.7% | Corroborated The same number is printed in 1 other lab document: 1 |
| high reasoning effort, the highest available · reported later, in Introducing GPT-5.4 mini and nano | 18.3% | |
| Humanity's Last ExamWith tools · high reasoning effort, the highest available; tools not named · reported later, in Introducing GPT-5.4 mini and nano | 31.6% | |
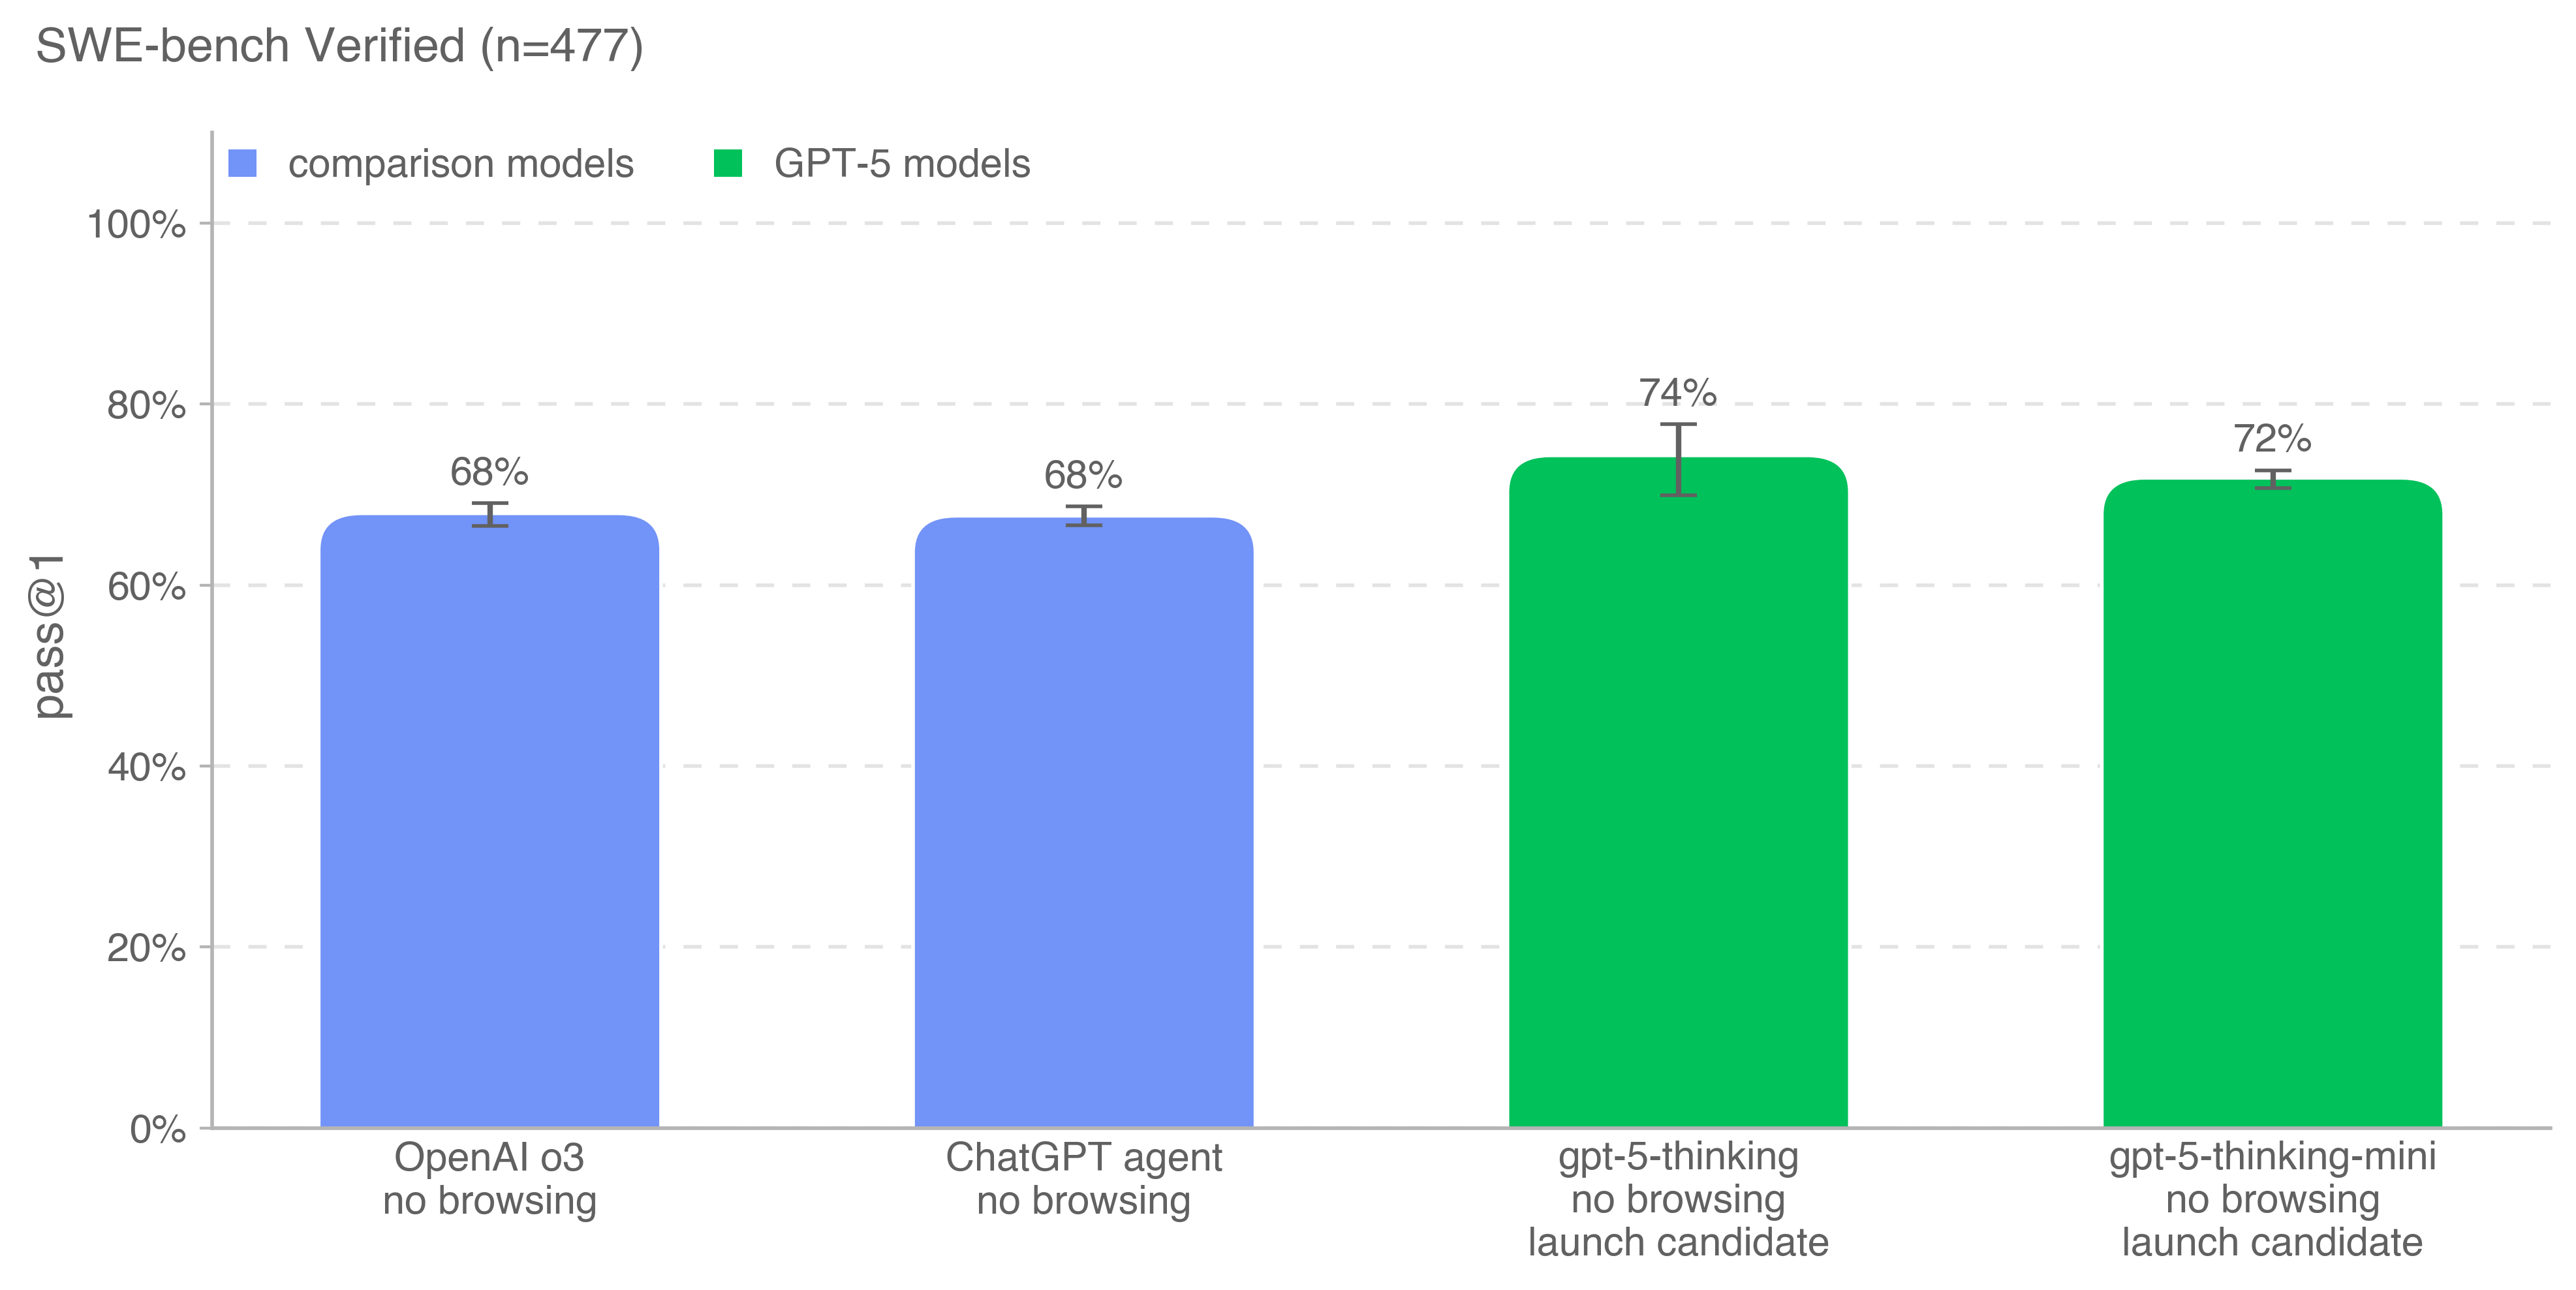
| SWE-bench Verifiedmaximum trained-in verbosity; no browsing; bash and apply_patch scaffold; 4 tries averaged; 477 of 500 tasks | 72% | |
| high reasoning effort; 477 of the 500 tasks · reported later, in Introducing GPT-5 for developers | 71.0% | |
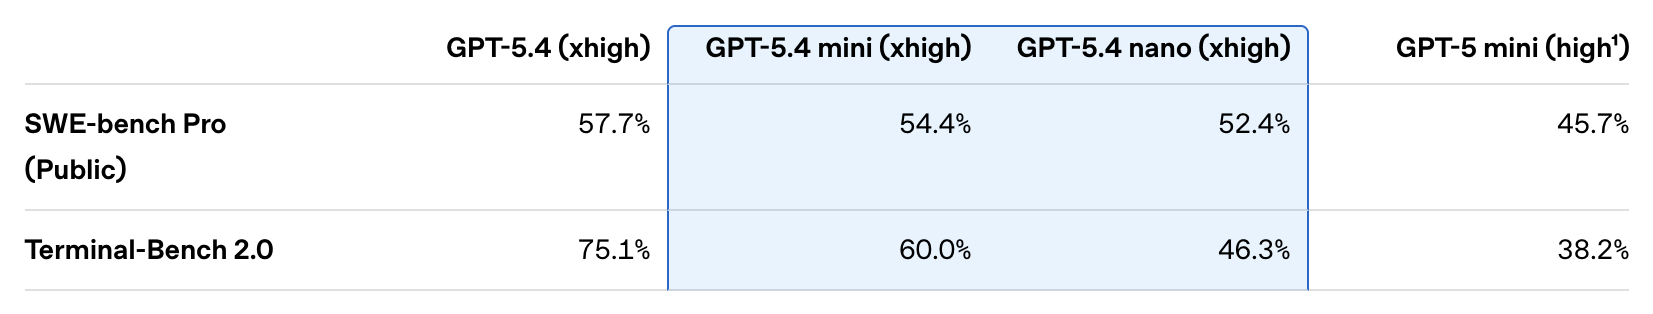
| SWE-bench Prohigh reasoning effort, the highest available · reported later, in Introducing GPT-5.4 mini and nano | 45.7% | |
| GPQA Diamondhigh reasoning effort; no tools · reported later, in Introducing GPT-5 for developers | 82.3% | Corroborated The same number is printed in 1 other lab document: 1 |
| high reasoning effort, the highest available · reported later, in Introducing GPT-5.4 mini and nano | 81.6% | |
| Terminal-Bench 2.0high reasoning effort, the highest available · reported later, in Introducing GPT-5.4 mini and nano | 38.2% | |
| AIME 2025No tools · high reasoning effort · reported later, in Introducing GPT-5 for developers | 91.1% | Corroborated The same number is printed in 1 other lab document: 1 |
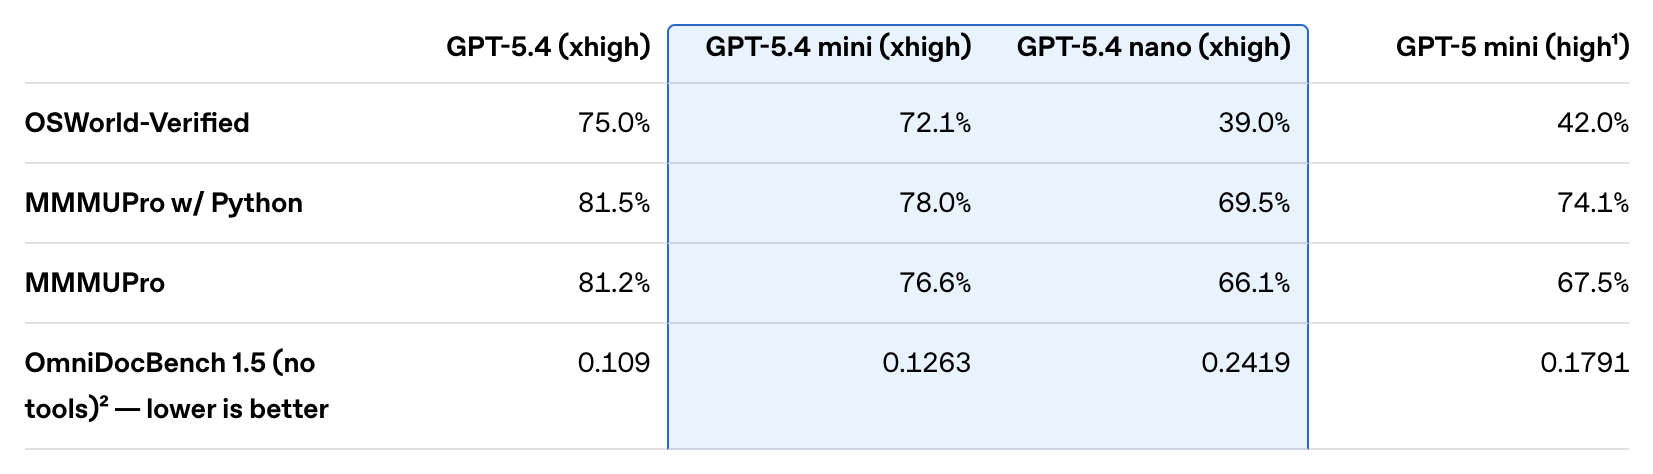
| OSWorld-Verifiedhigh reasoning effort, the highest available · reported later, in Introducing GPT-5.4 mini and nano | 42.0% | |
| HMMT February 2025No tools · high reasoning effort · reported later, in Introducing GPT-5 for developers | 87.8% | Corroborated The same number is printed in 1 other lab document: 1 |
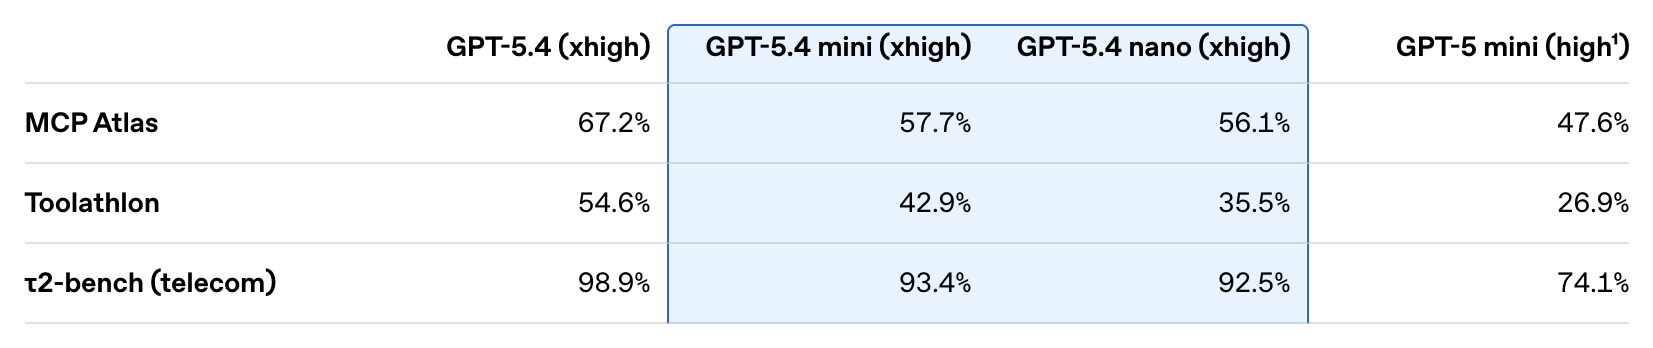
| τ²-benchTelecom · high reasoning effort · reported later, in Introducing GPT-5 for developers | 74.1% | Corroborated The same number is printed in 1 other lab document: 1 |
| τ²-benchRetail · high reasoning effort · reported later, in Introducing GPT-5 for developers | 78.3% | |
| τ²-benchAirline · high reasoning effort · reported later, in Introducing GPT-5 for developers | 60.0% | |
| MCP Atlashigh reasoning effort, the highest available · reported later, in Introducing GPT-5.4 mini and nano | 47.6% | |