Frontier Log

Benchmark · InactiveSuperseded by Agents' Last Exam v1.1

Agents' Last Exam v1

Created by UC Berkeley RDI, 3 Jun 2026 · Higher is better · Website

010203040Jul 2026Oct 202628.5%GLM-5.322.8%Hy4 preview17.1%Hy3010203040Jul 2026Oct 202628.5%GLM-5.322.8%Hy4 preview17.1%Hy3

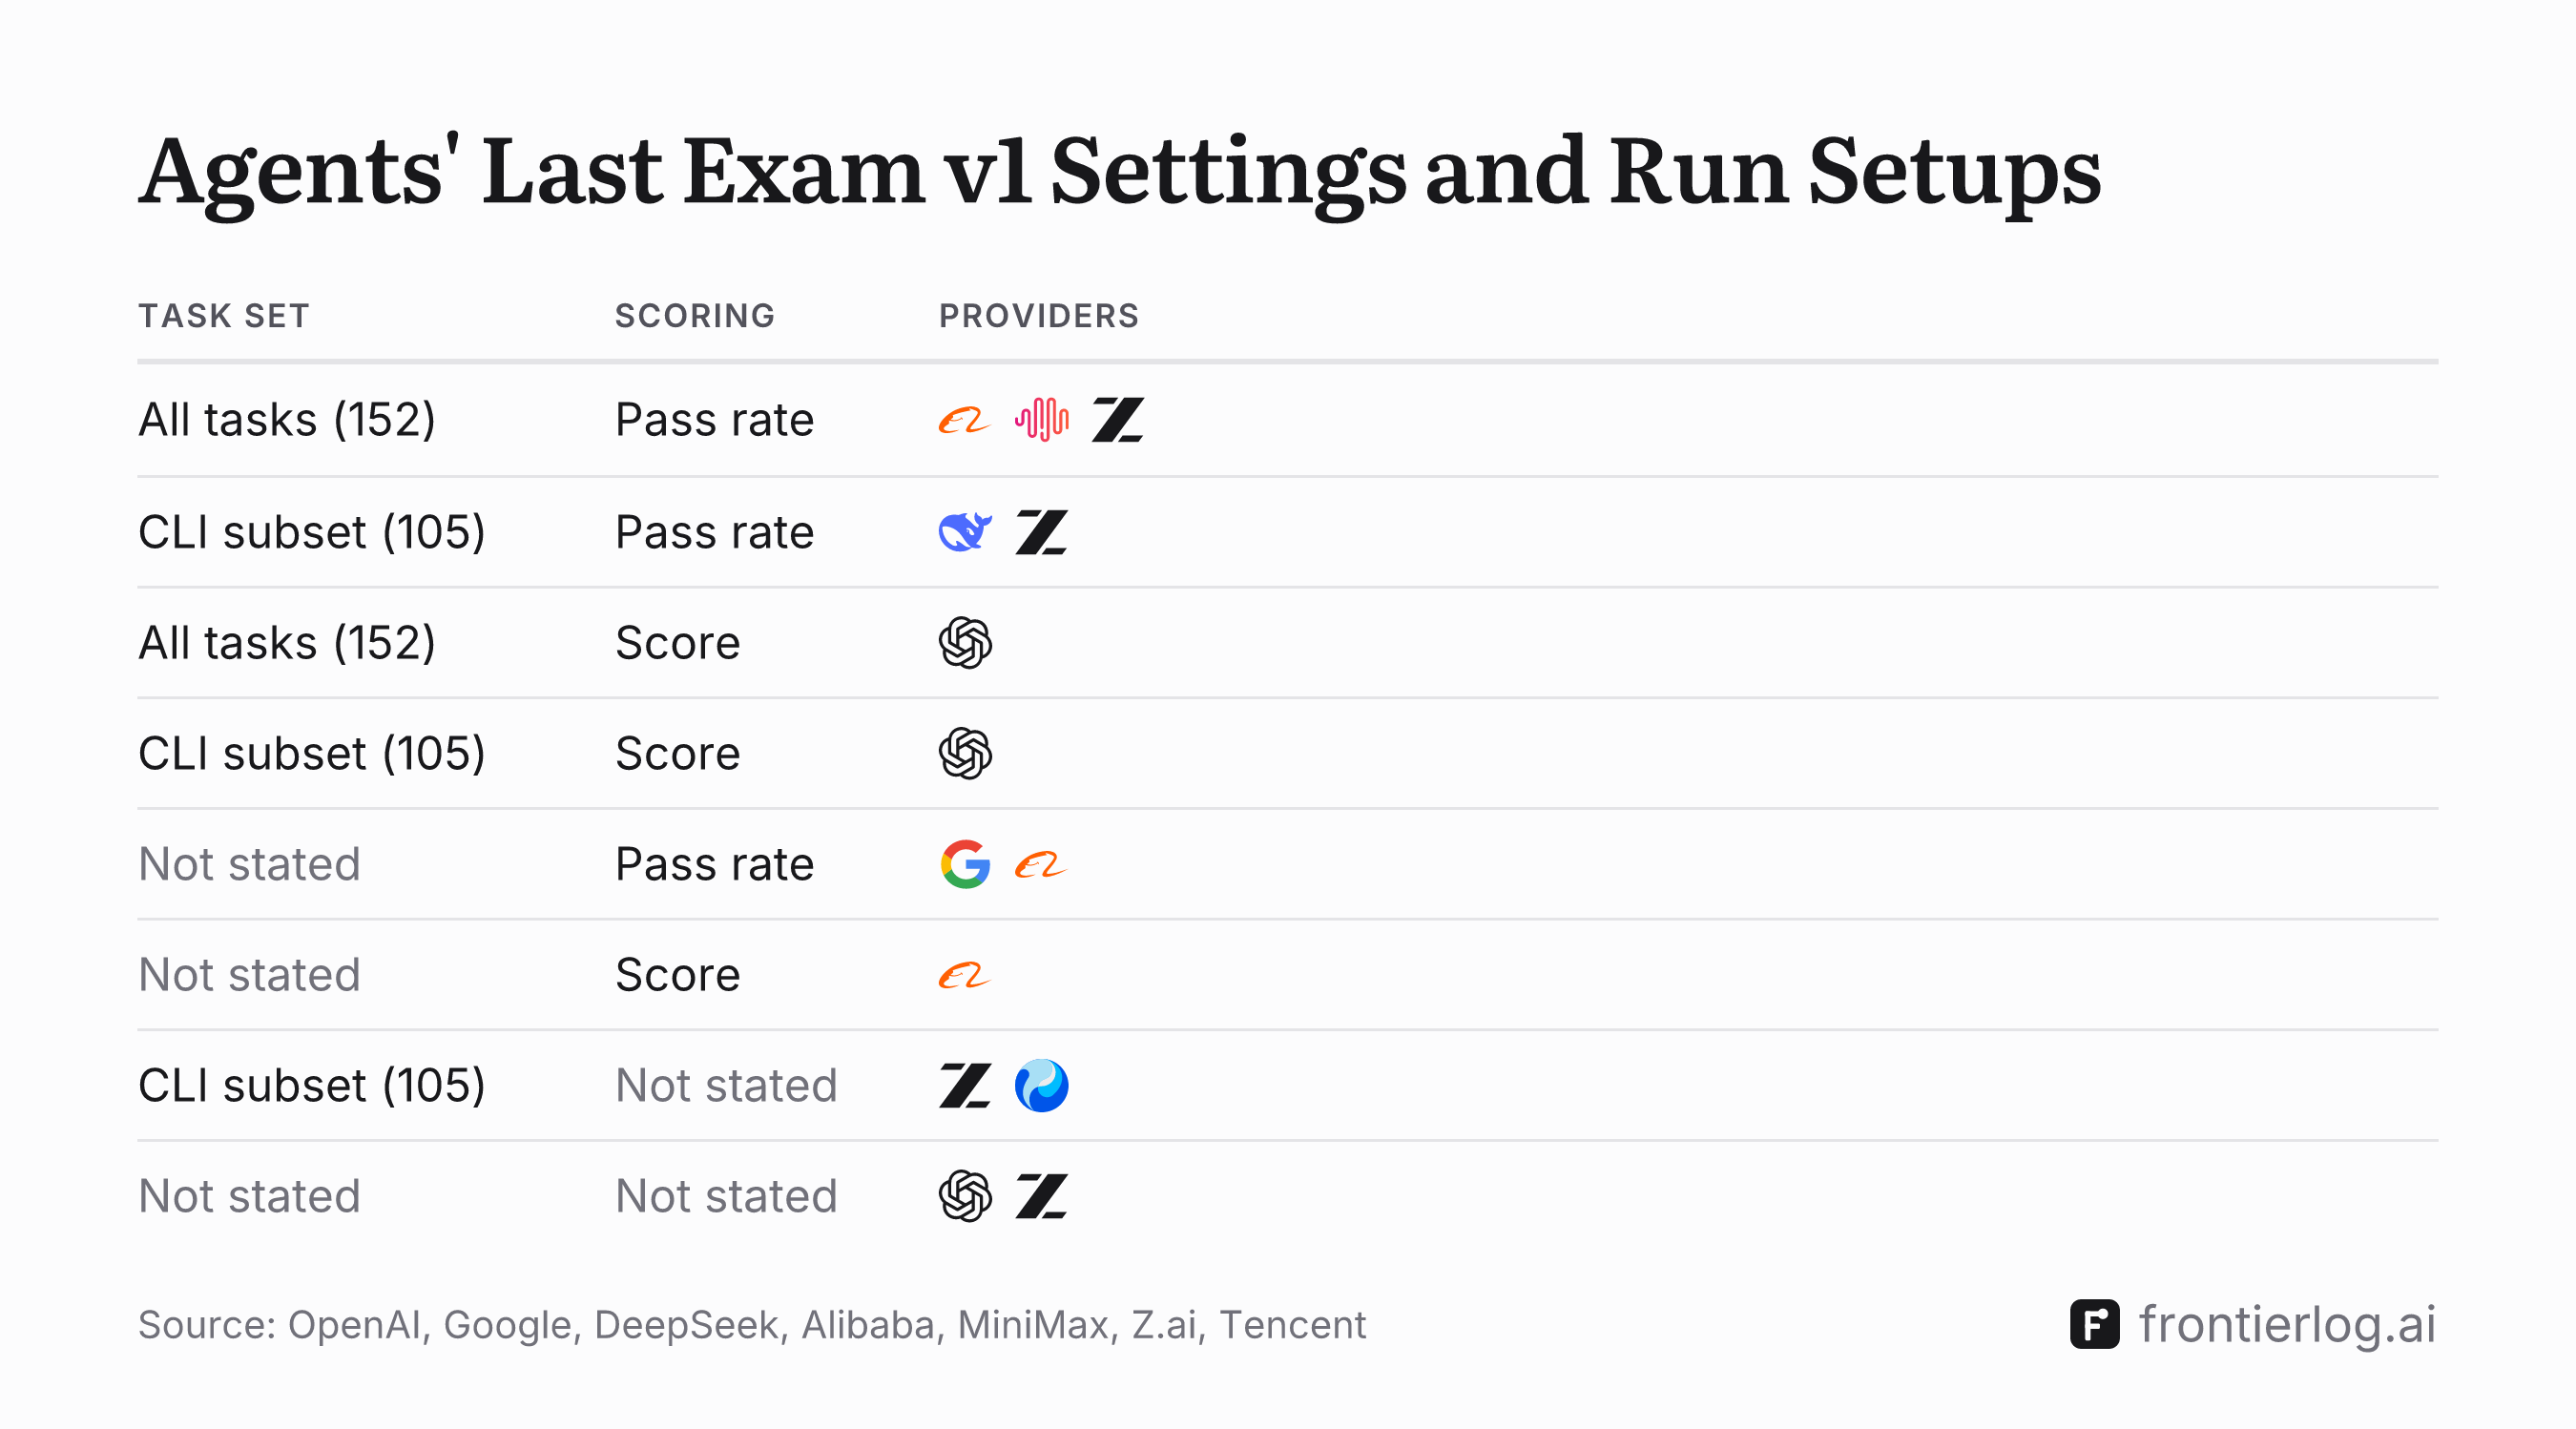
Settings and run setups

Task setScoringProviders
All tasks (152)Pass rateAlibabaMiniMaxZ.ai
CLI subset (105)Pass rateDeepSeekZ.ai
All tasks (152)ScoreOpenAI
CLI subset (105)ScoreOpenAI
Not statedPass rateGoogleAlibaba
Not statedScoreAlibaba
CLI subset (105)Not statedZ.aiTencent
Not statedNot statedOpenAIZ.ai

Download image

Results

ModelScoreSource
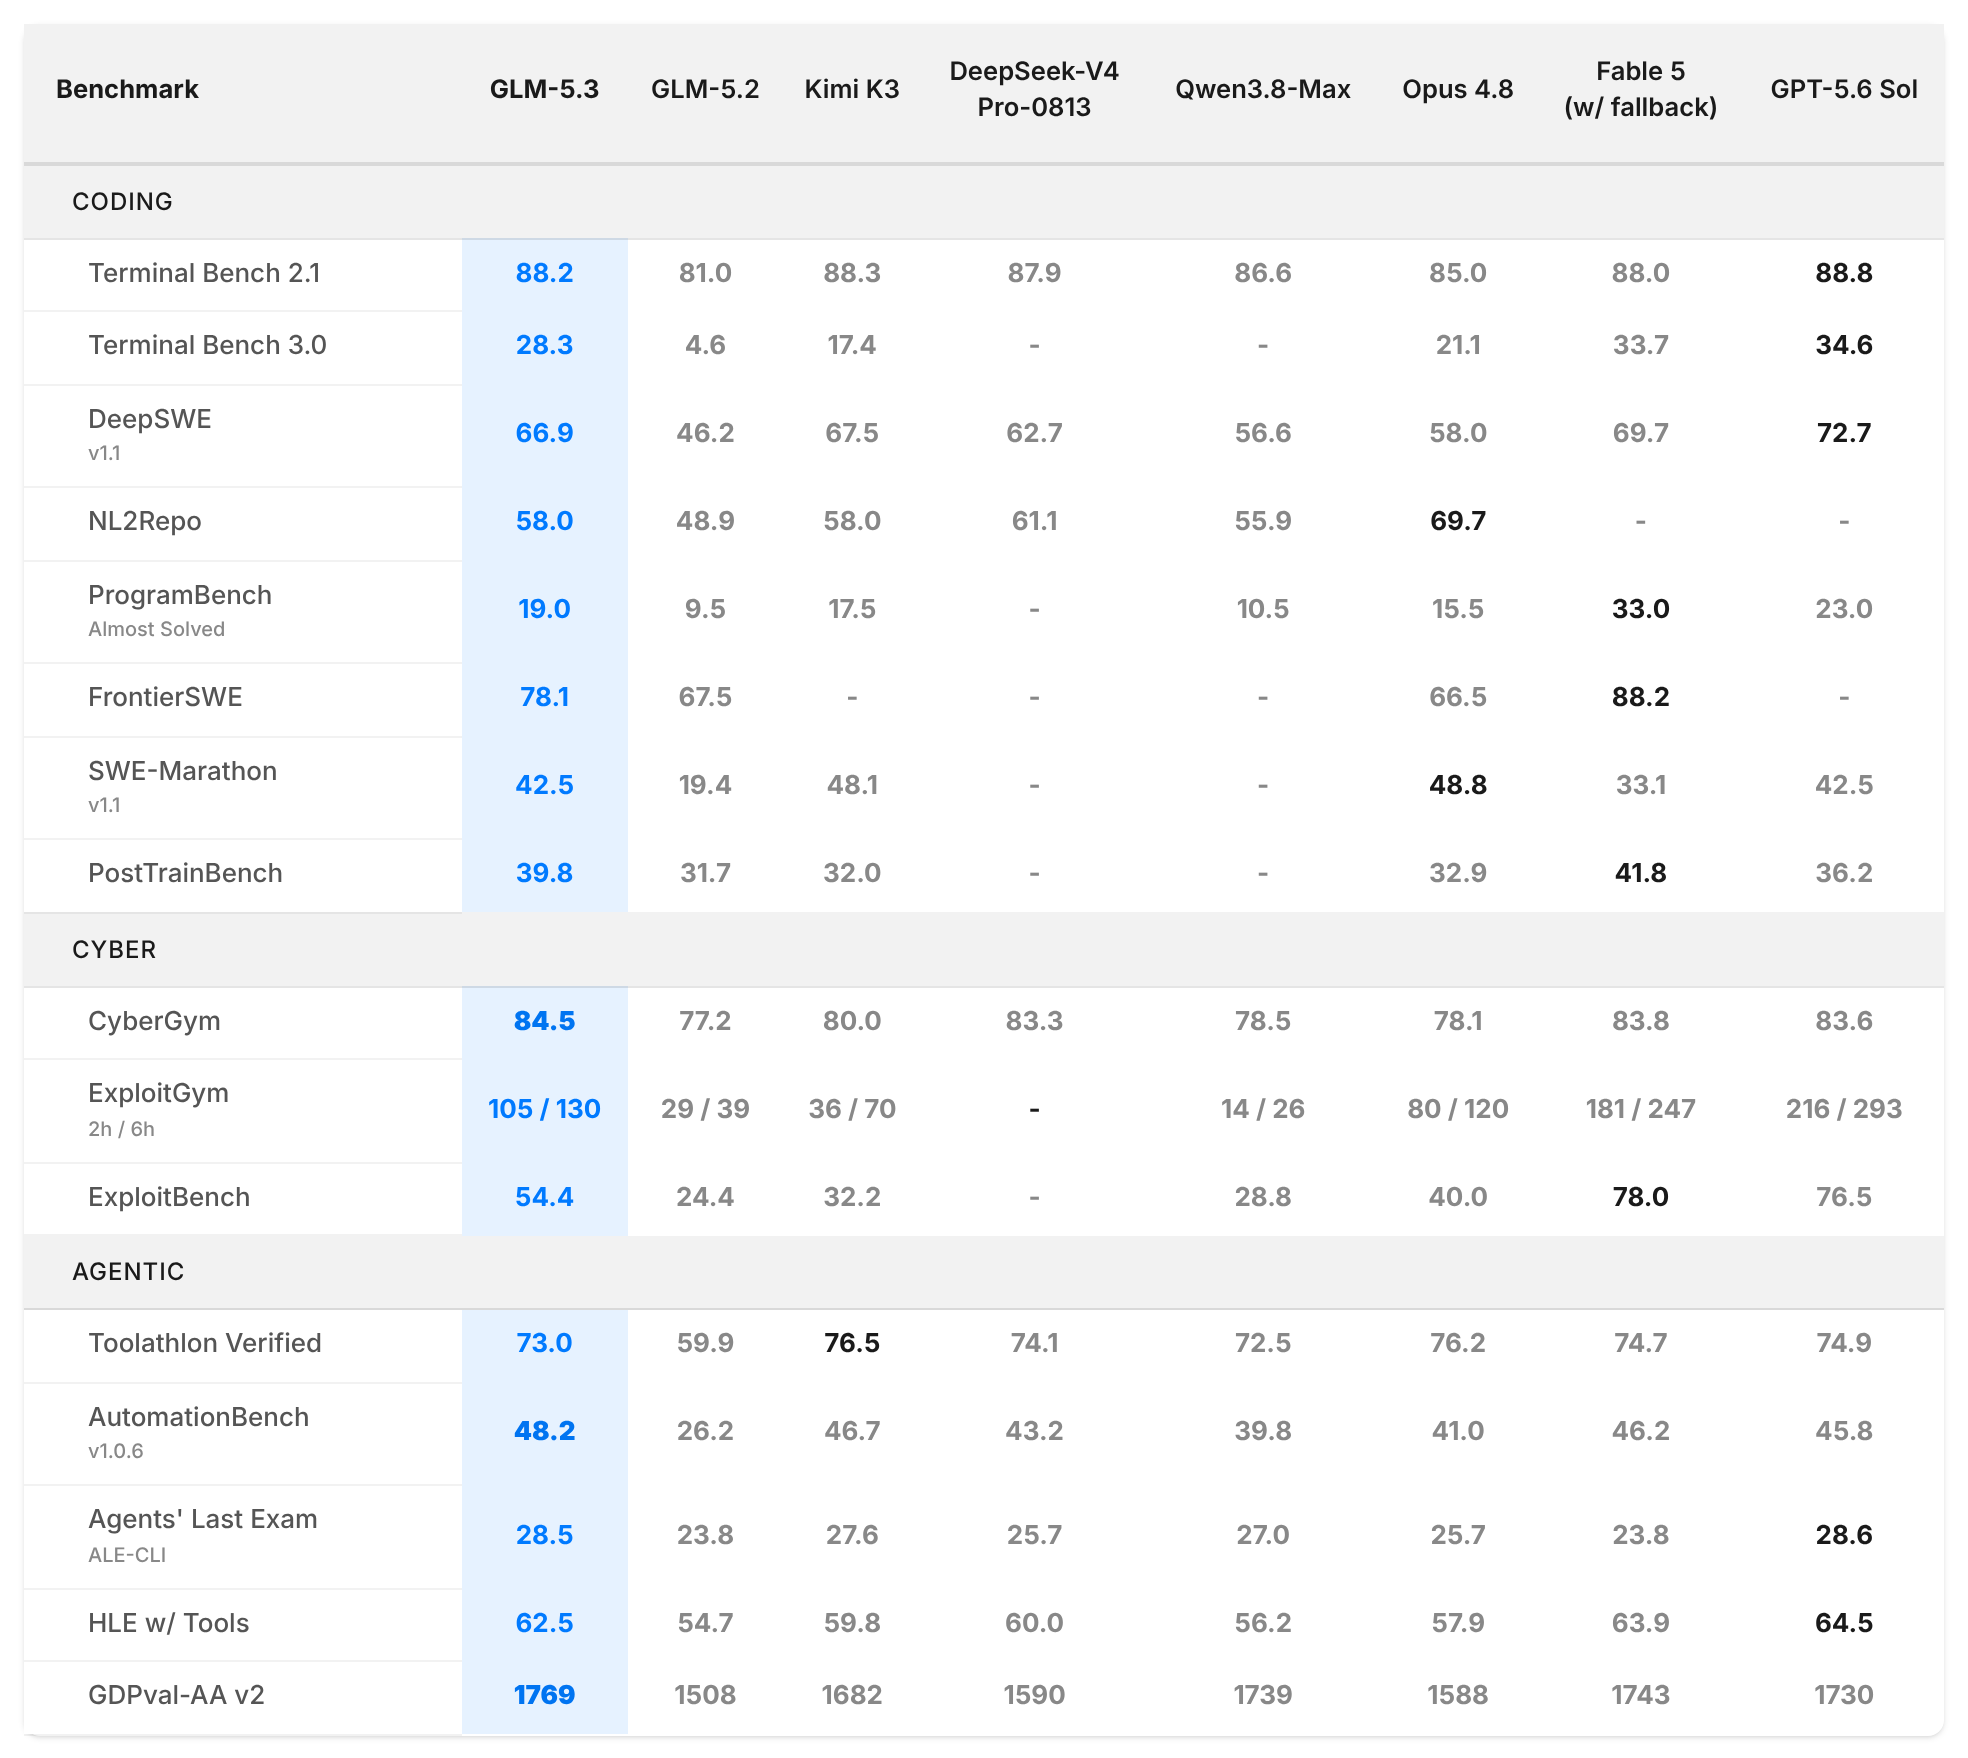
GLM-5.314 Aug 202628.5%GLM-5.3: Frontier Coding with Emergent Cyber CapabilitiesCorroborated The same number is printed in 4 other lab documents. The first 3 are linked: 1 2 3Claude Code harness · max effort · 1M context, 4h timeout, up to 8h per taskOur capture
Hy4 preview28 Aug 202622.8%Introducing Hy4 previewCorroborated The same number is printed in 1 other lab document: 1Claude Code harness · highest available reasoning setting · up to 12h per taskSource image
Hy36 Jul 202617.1%Introducing Hy4 previewCorroborated The same number is printed in 1 other lab document: 1Claude Code harness · highest available reasoning setting · up to 12h per task · re-evaluated at Hy4 preview launch · reported laterSource image
All benchmarks