gpt-oss-20b
Announced on openai.com
Benchmark results
| Benchmark | Score | Source check |
|---|---|---|
| SWE-bench Verifiedhigh reasoning effort | 60.7% | |
| low reasoning effort | 37.4% | |
| medium reasoning effort | 53.2% | |
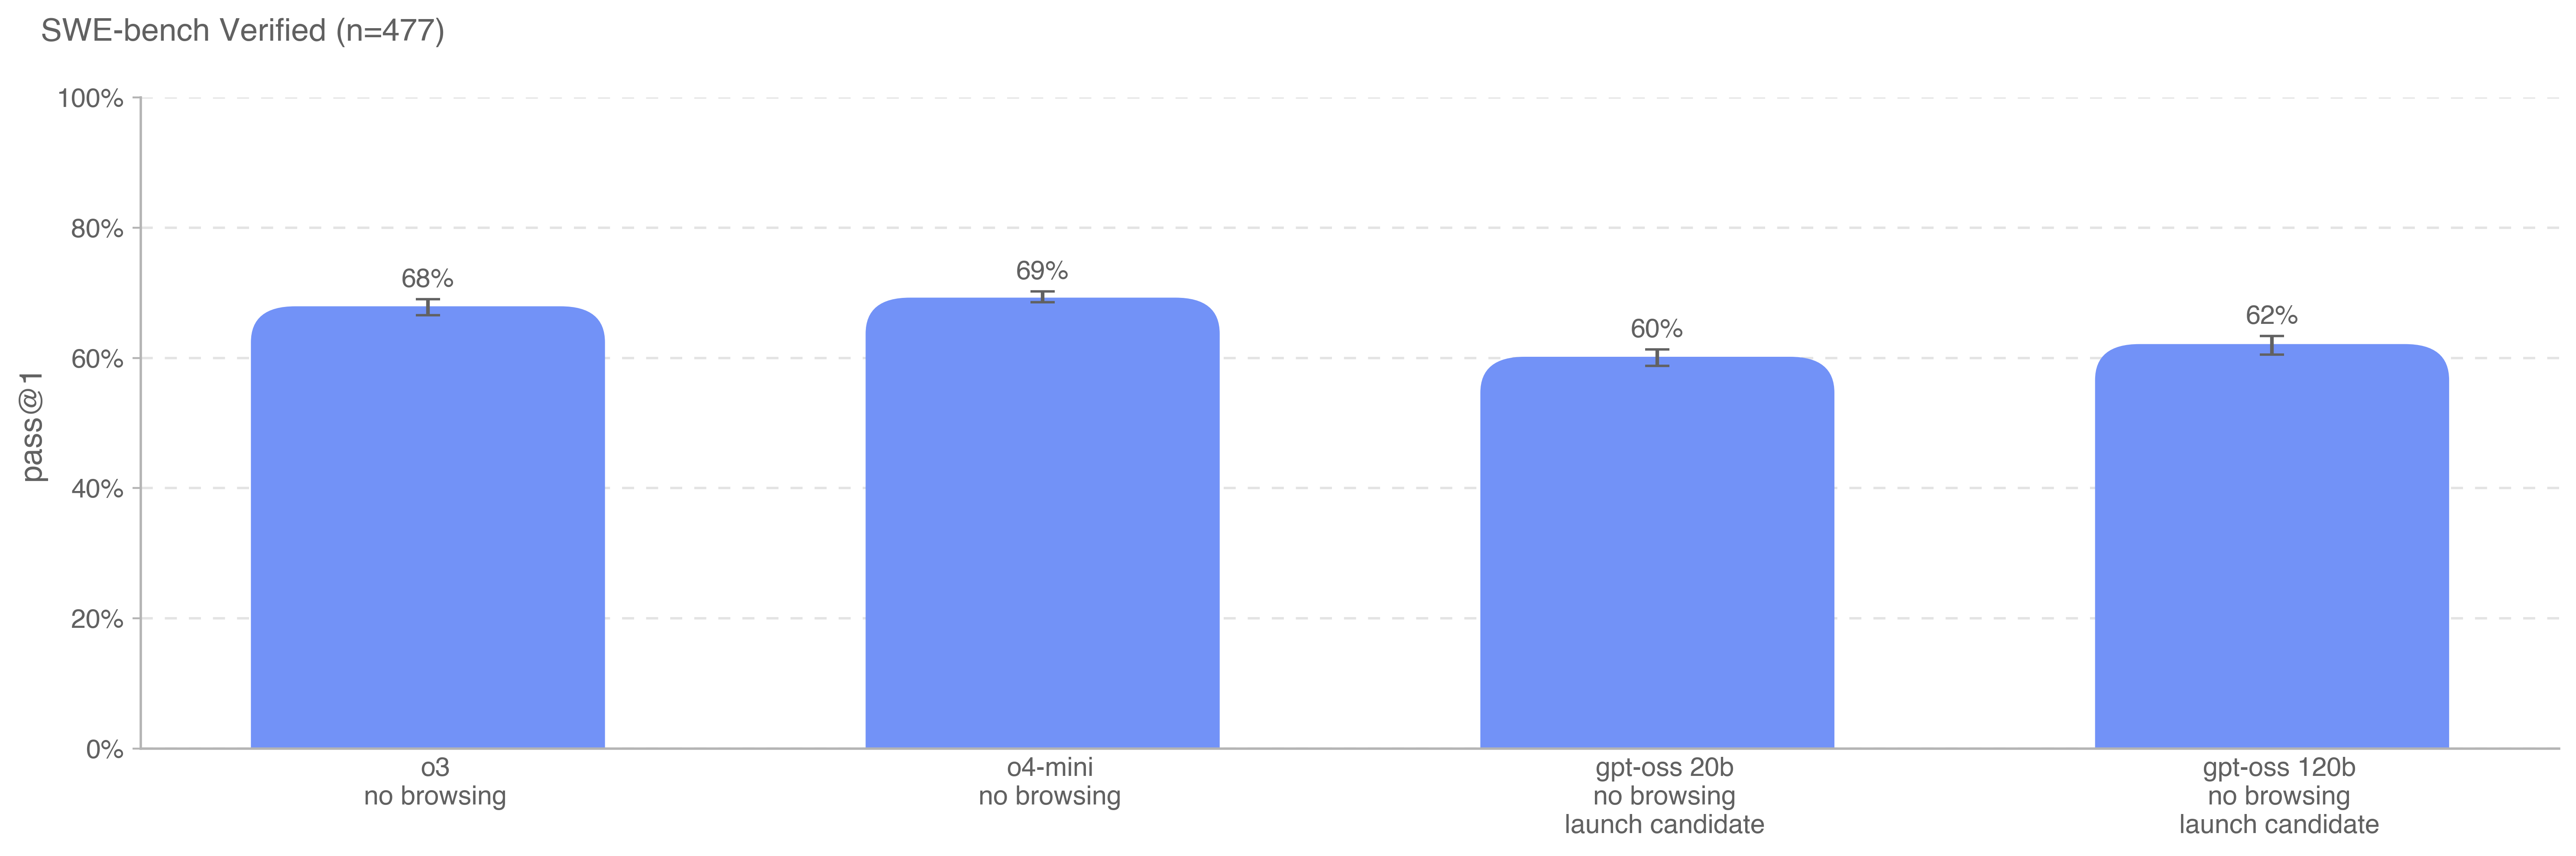
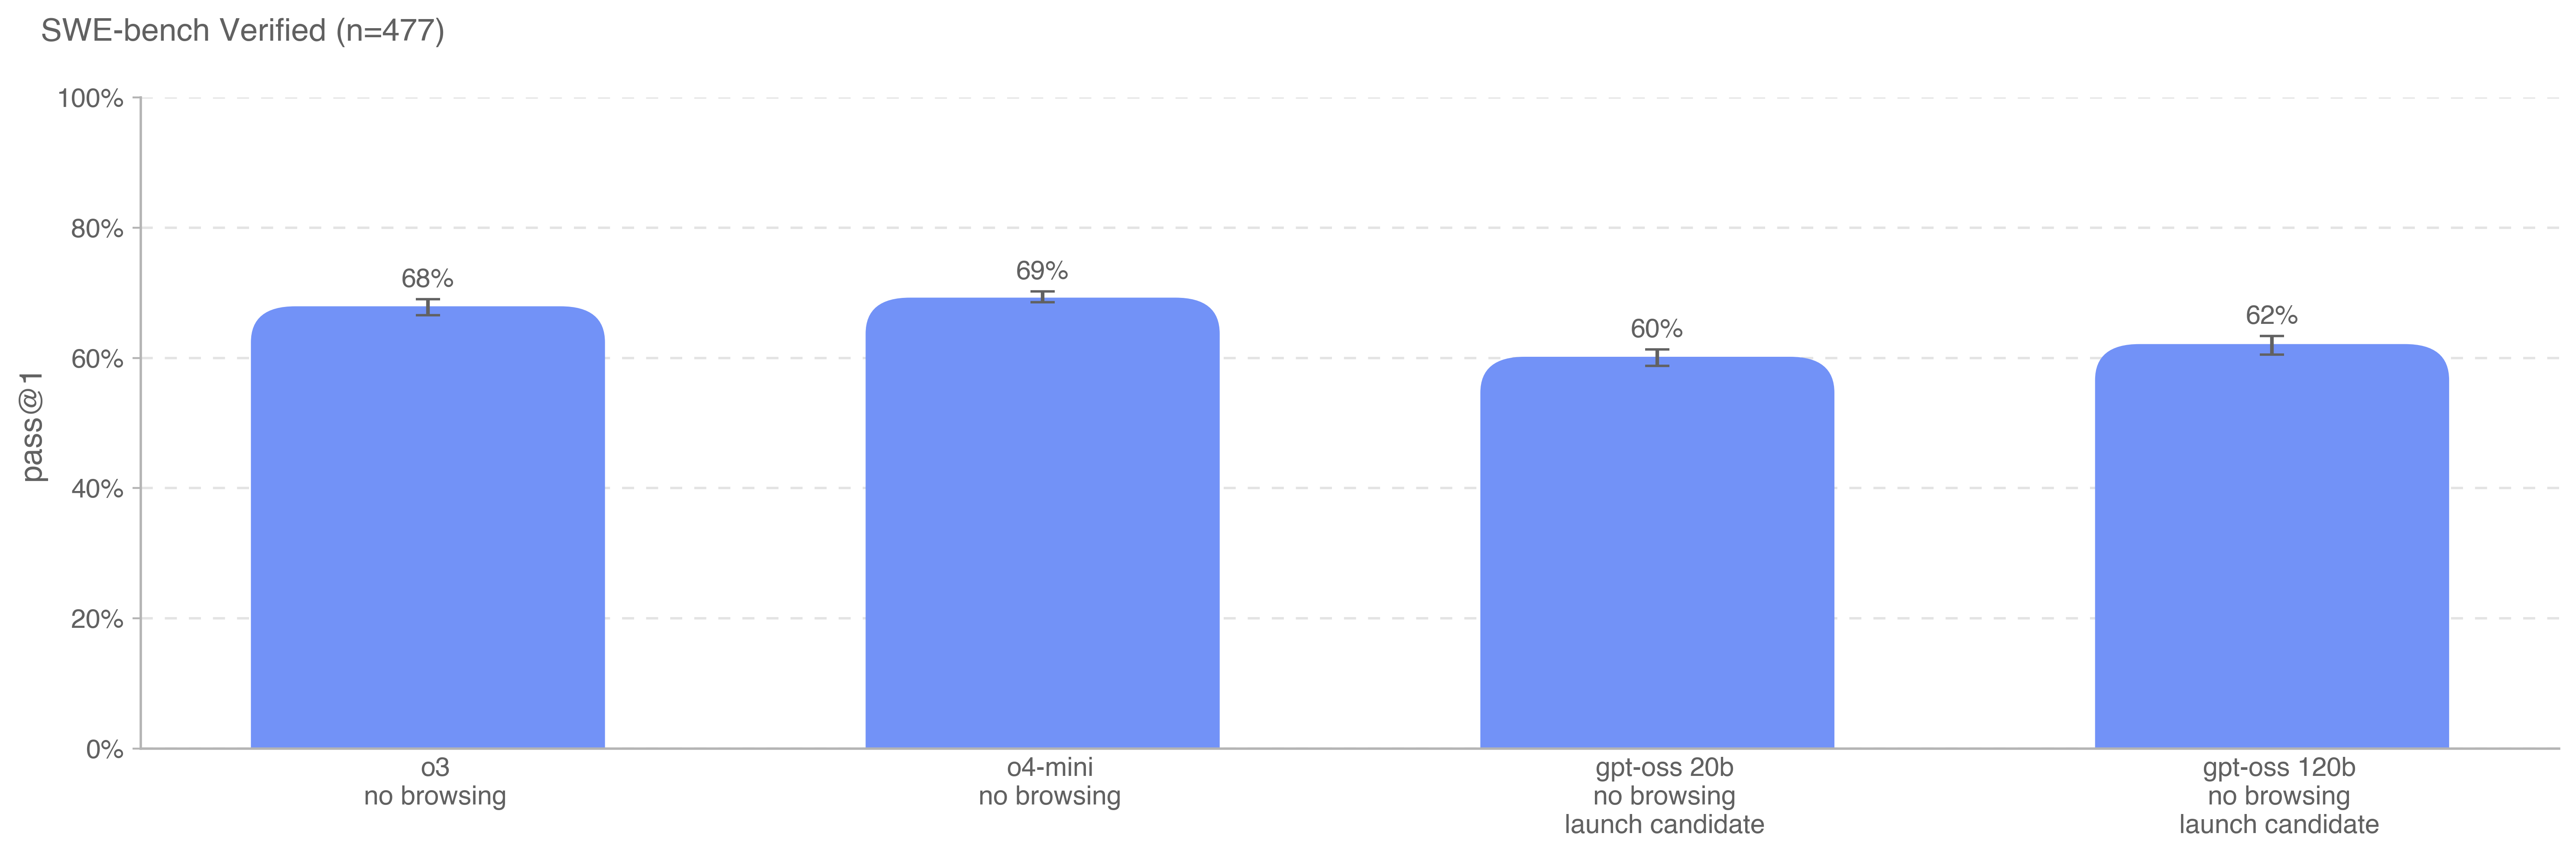
| preparedness run; no browsing; scaffold not stated; 477 of the 500 tasks | 60% | |
| AIME 2024No tools · high reasoning effort | 92.1% | |
| low reasoning effort | 42.1% | |
| medium reasoning effort | 80.0% | |
| AIME 2024With tools · high reasoning effort; tools | 96% | |
| low reasoning effort; tools · in gpt-oss-120b & gpt-oss-20b Model Card | 61.2% | |
| medium reasoning effort; tools · in gpt-oss-120b & gpt-oss-20b Model Card | 86.0% | |
| AIME 2025No tools · high reasoning effort | 91.7% | |
| low reasoning effort | 37.1% | |
| medium reasoning effort | 72.1% | |
| AIME 2025With tools · high reasoning effort; tools | 98.7% | |
| low reasoning effort; tools · in gpt-oss-120b & gpt-oss-20b Model Card | 57.5% | |
| medium reasoning effort; tools · in gpt-oss-120b & gpt-oss-20b Model Card | 90.4% |
Sources
Reported by OpenAI
- gpt-oss-120b & gpt-oss-20b Model Carddeploymentsafety.openai.com · 5 Aug 2025
Original image - Introducing gpt-ossopenai.com · 5 Aug 2025